量化轮动系统建设手记(四):诚实性工程——我们如何主动把策略数字从 8.6% 下调到 5.2%
这一篇没有新功能。记录的是过去几天里最有价值、也最不体面的一类工作:把已经跑出来的漂亮数字,亲手变丑。
上一篇(三)的结尾留下一个 +6.74% 的样本内结果,后来经过样本外验证达到 +8.6%/年。而本周做实的一件事是:这个 8.6%,高估了。下面是完整的「排雷 → 修复 → 复检 → 稳健性」过程。
一、退市股去哪了?
核查起因很简单:随手查了几只知名退市股(乐视、康得新等)——全库零记录。再一比对:数据库里的 5500 余只股票,恰好等于「当前仍上市」的集合。也就是说,历史上所有退市股从未进入过样本。
这带来一个经典陷阱:幸存者偏差。只用「活到今天」的股票做研究,等于偷偷剔除了所有归零的失败者。对均值型策略影响有限,但对「买近期跌得多的股票博反弹」这类反转逻辑,是致命的——因为有些大跌的股票不是会反弹,而是会退市。
修复动作:从公开数据源回填了 250 只退市股、约 42 万行日线(自 2016 年以来),并做了偏差量化:
| 口径 | 仅当前上市(原) | 含退市股(修正) | 偏差量级 |
|---|---|---|---|
| 全市场等权月收益 | +0.689% | +0.593% | -1.2%/年 |
| 「上月最跌」组合月收益 | -12.15% | -12.46% | -3.7%/年 |
恰好,我们的选股模型正是偏反转逻辑。修正后模型复检:排序能力几乎不受影响(IC 0.106 → 0.107),但可执行组合的月均超额从 +2.08% 降到 +1.78%——每月的期待值下修了 0.3 个百分点。这是第一笔"变丑"。
二、数据修补的连锁反应
顺藤摸瓜排查板块数据时,发现了两个更隐蔽的问题:
① 代号误用。某个板块的数据源一直取的是一个"稀疏系列"(2017-2021 大段空缺),而正确系列其实有完整历史——多年数据看起来"本来就缺",其实是取错了。
② 断档污染。更阴险:旧的数据构建在断档处计算动量时,把跨越 5 年空洞的"跳变"算进了指标。修复前某日的 20 日动量显示 +62.9%,真实值约 +1.4%。这类错误肉眼几乎不可能发现——除非专门做连续性检查。
修复:补齐 1,191 行缺失历史、全史校准 1,256 行,并为此后所有回填脚本立下规矩:先验证公式一致性(用重叠区间对账),再写库。
三、复检:8.6% 变成 5.2%
数据变了,此前所有基于它的回测结论都要重新跑。滚动样本外验证(12 折:训练 3 年 → 测试 6 个月)复检结果:
| 配置 | 修复前 | 修复后 | 去煤消融 |
|---|---|---|---|
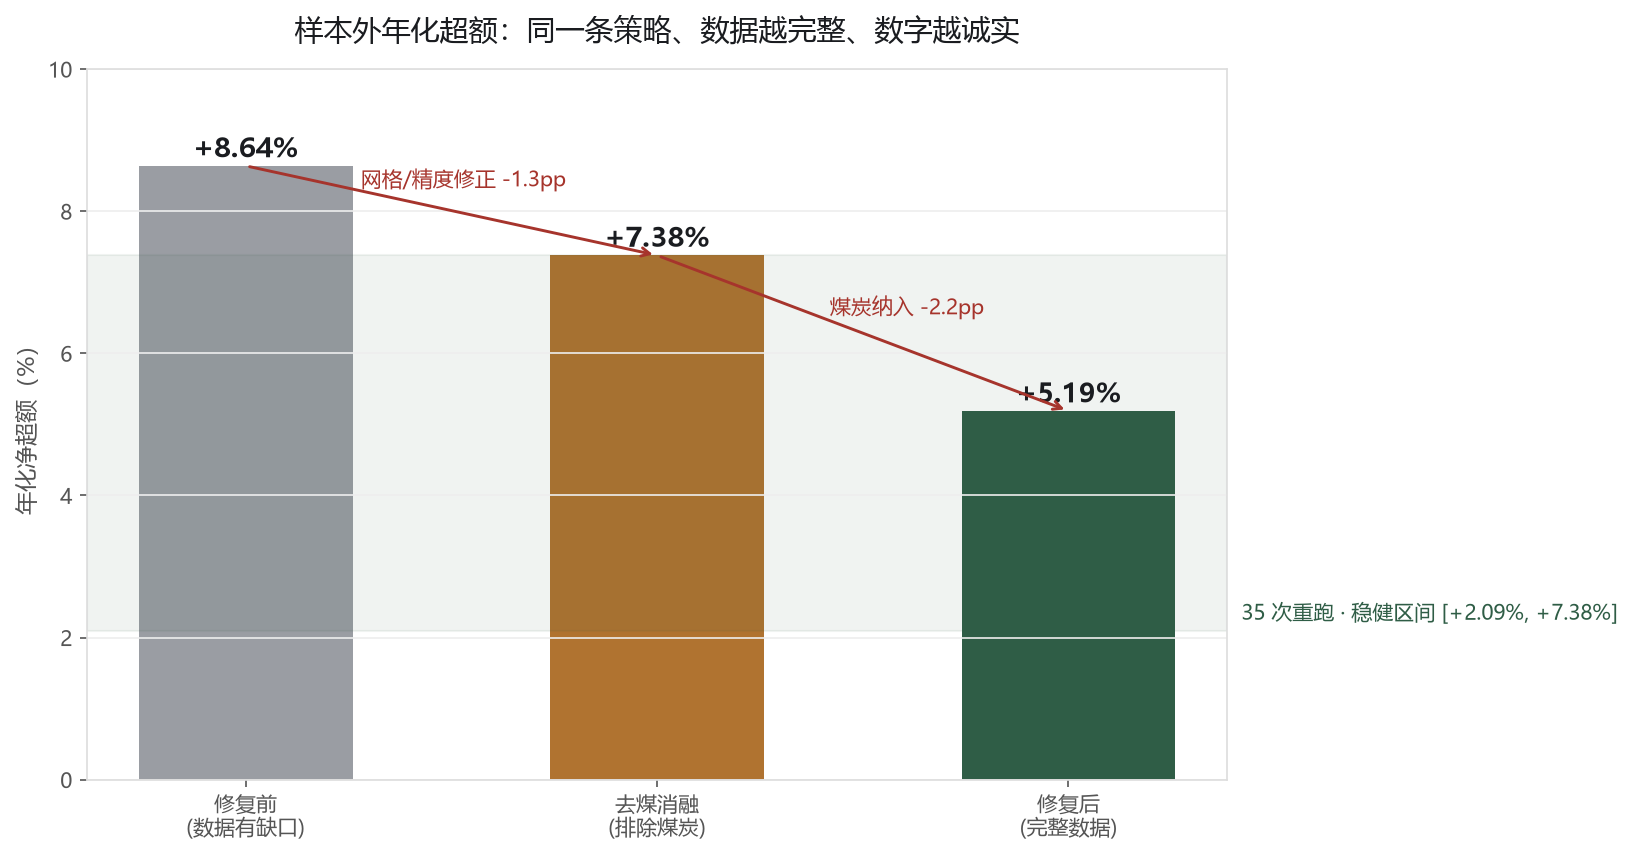
| 主配置(MA120 开关) | +8.64% / IR 1.23 | +5.19% / IR 0.77 | +7.38% / IR 1.09 |
| +波动率目标化 | +8.11% | +5.09% | +6.89% |
| 动态选择版 | +7.04% | +3.27% | +5.35% |
用消融实验拆解差异:把一个此前缺失历史的板块(煤炭)单独拿出来对比,它贡献了约 -2.2 个百分点的下修;其余约 -1.3 个百分点来自日期网格与数据精度的修正。同时暴露了一个此前没意识到的问题:这类周频策略对"决策日"和数据细节高度敏感——同一套逻辑,数据的一点变化会让具体买卖序列完全不同。
四、稳健性研究:跑 35 次回答"靠不靠谱"
既然单点数字这么敏感,就应该用「分布」而不是「单点」来评估。于是做了两组系统性扰动重跑:
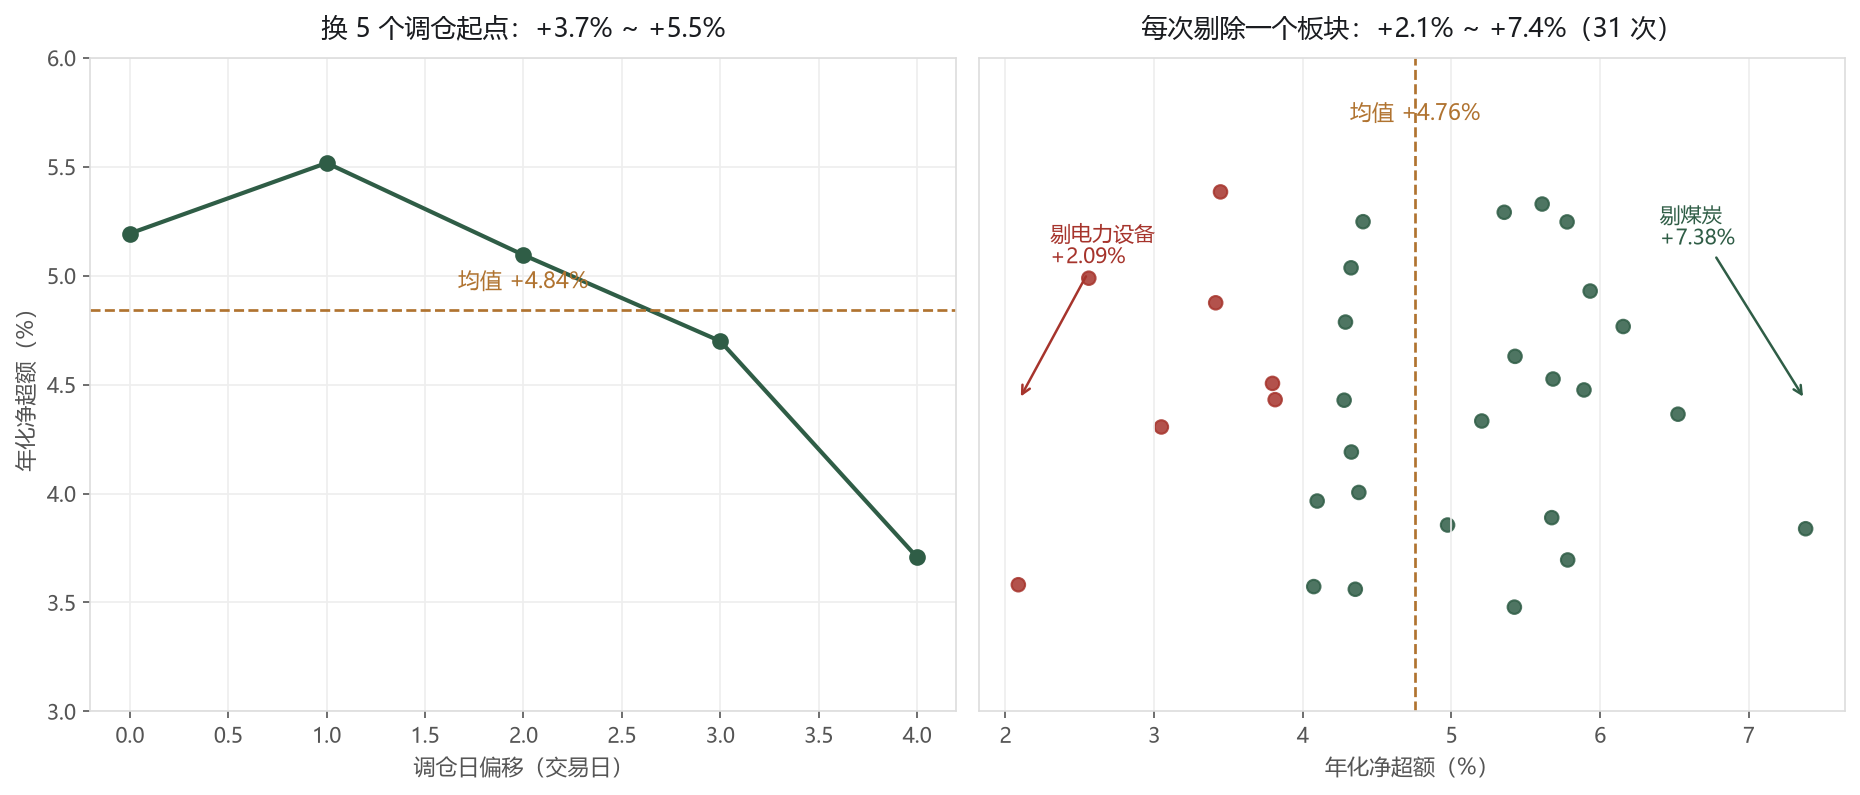
- 网格偏移扫描:把每周调仓的"起点"依次挪 0~4 个交易日,重跑 5 次——回答"如果当初选的调仓日不同,结果会怎样";
- 留一板块法:每次剔除一个板块重跑,共 31 次——回答"收益是不是靠个别板块撑起来的"。
结果:偏移扫描区间 +3.7% ~ +5.5%;留一板块区间 +2.1% ~ +7.4%。两个发现值得全文引用:
- 收益高度集中:剔除单一板块(电力设备)后,结果从 +5.2% 掉到 +2.1%——历史超额的大头来自一个板块的一轮大周期。名义上持有 8 个行业很"分散",但信号贡献度并不分散;
- 有的板块是拖累:剔除另一个板块(煤炭)后结果反而升到 +7.4%——说明动量逻辑在该板块上反复吃亏。
五、看不见的工程质量
这轮工作的副产品,是把"数据质量"从人肉检查升级成了自动化:现在每天有 19 项例行体检(表新鲜度、板块覆盖度、备份新鲜度等)。上线当天它就抓到一个真实故障——某个每日数据管道其实已经悄悄崩溃了两天(一个日期类型的兼容性问题),修复并补算了 13 万行数据。如果没有巡检,这个问题可能再潜伏一周。
同时建立了备份双轨:核心派生数据每日、源数据每周,另有异地冷备包(只含不可重建的研究成果)。「研究的可复现性」才算真正落地。
结语:把数字变丑,是赚的
8.6% → 5.2%,从传播角度这是一次"退步"。但对我们来说,这三件事同时发生了:数字更接近真实、知道了收益的集中风险、建立了发现同类问题的机制。研究系统最贵的资产不是某个漂亮的回测曲线,而是"它说真话"的能力。下一篇会进入策略的"最后一公里":盘后自动化流水线与每日研究日报。
免责声明:本系列为个人技术研究记录,系统为个人研究工具,回测结果基于历史数据、不代表未来表现,不构成任何投资建议。